Más con menos: 1.200 tareas bastaron para duplicar el rendimiento en Terminal-Bench 4.1
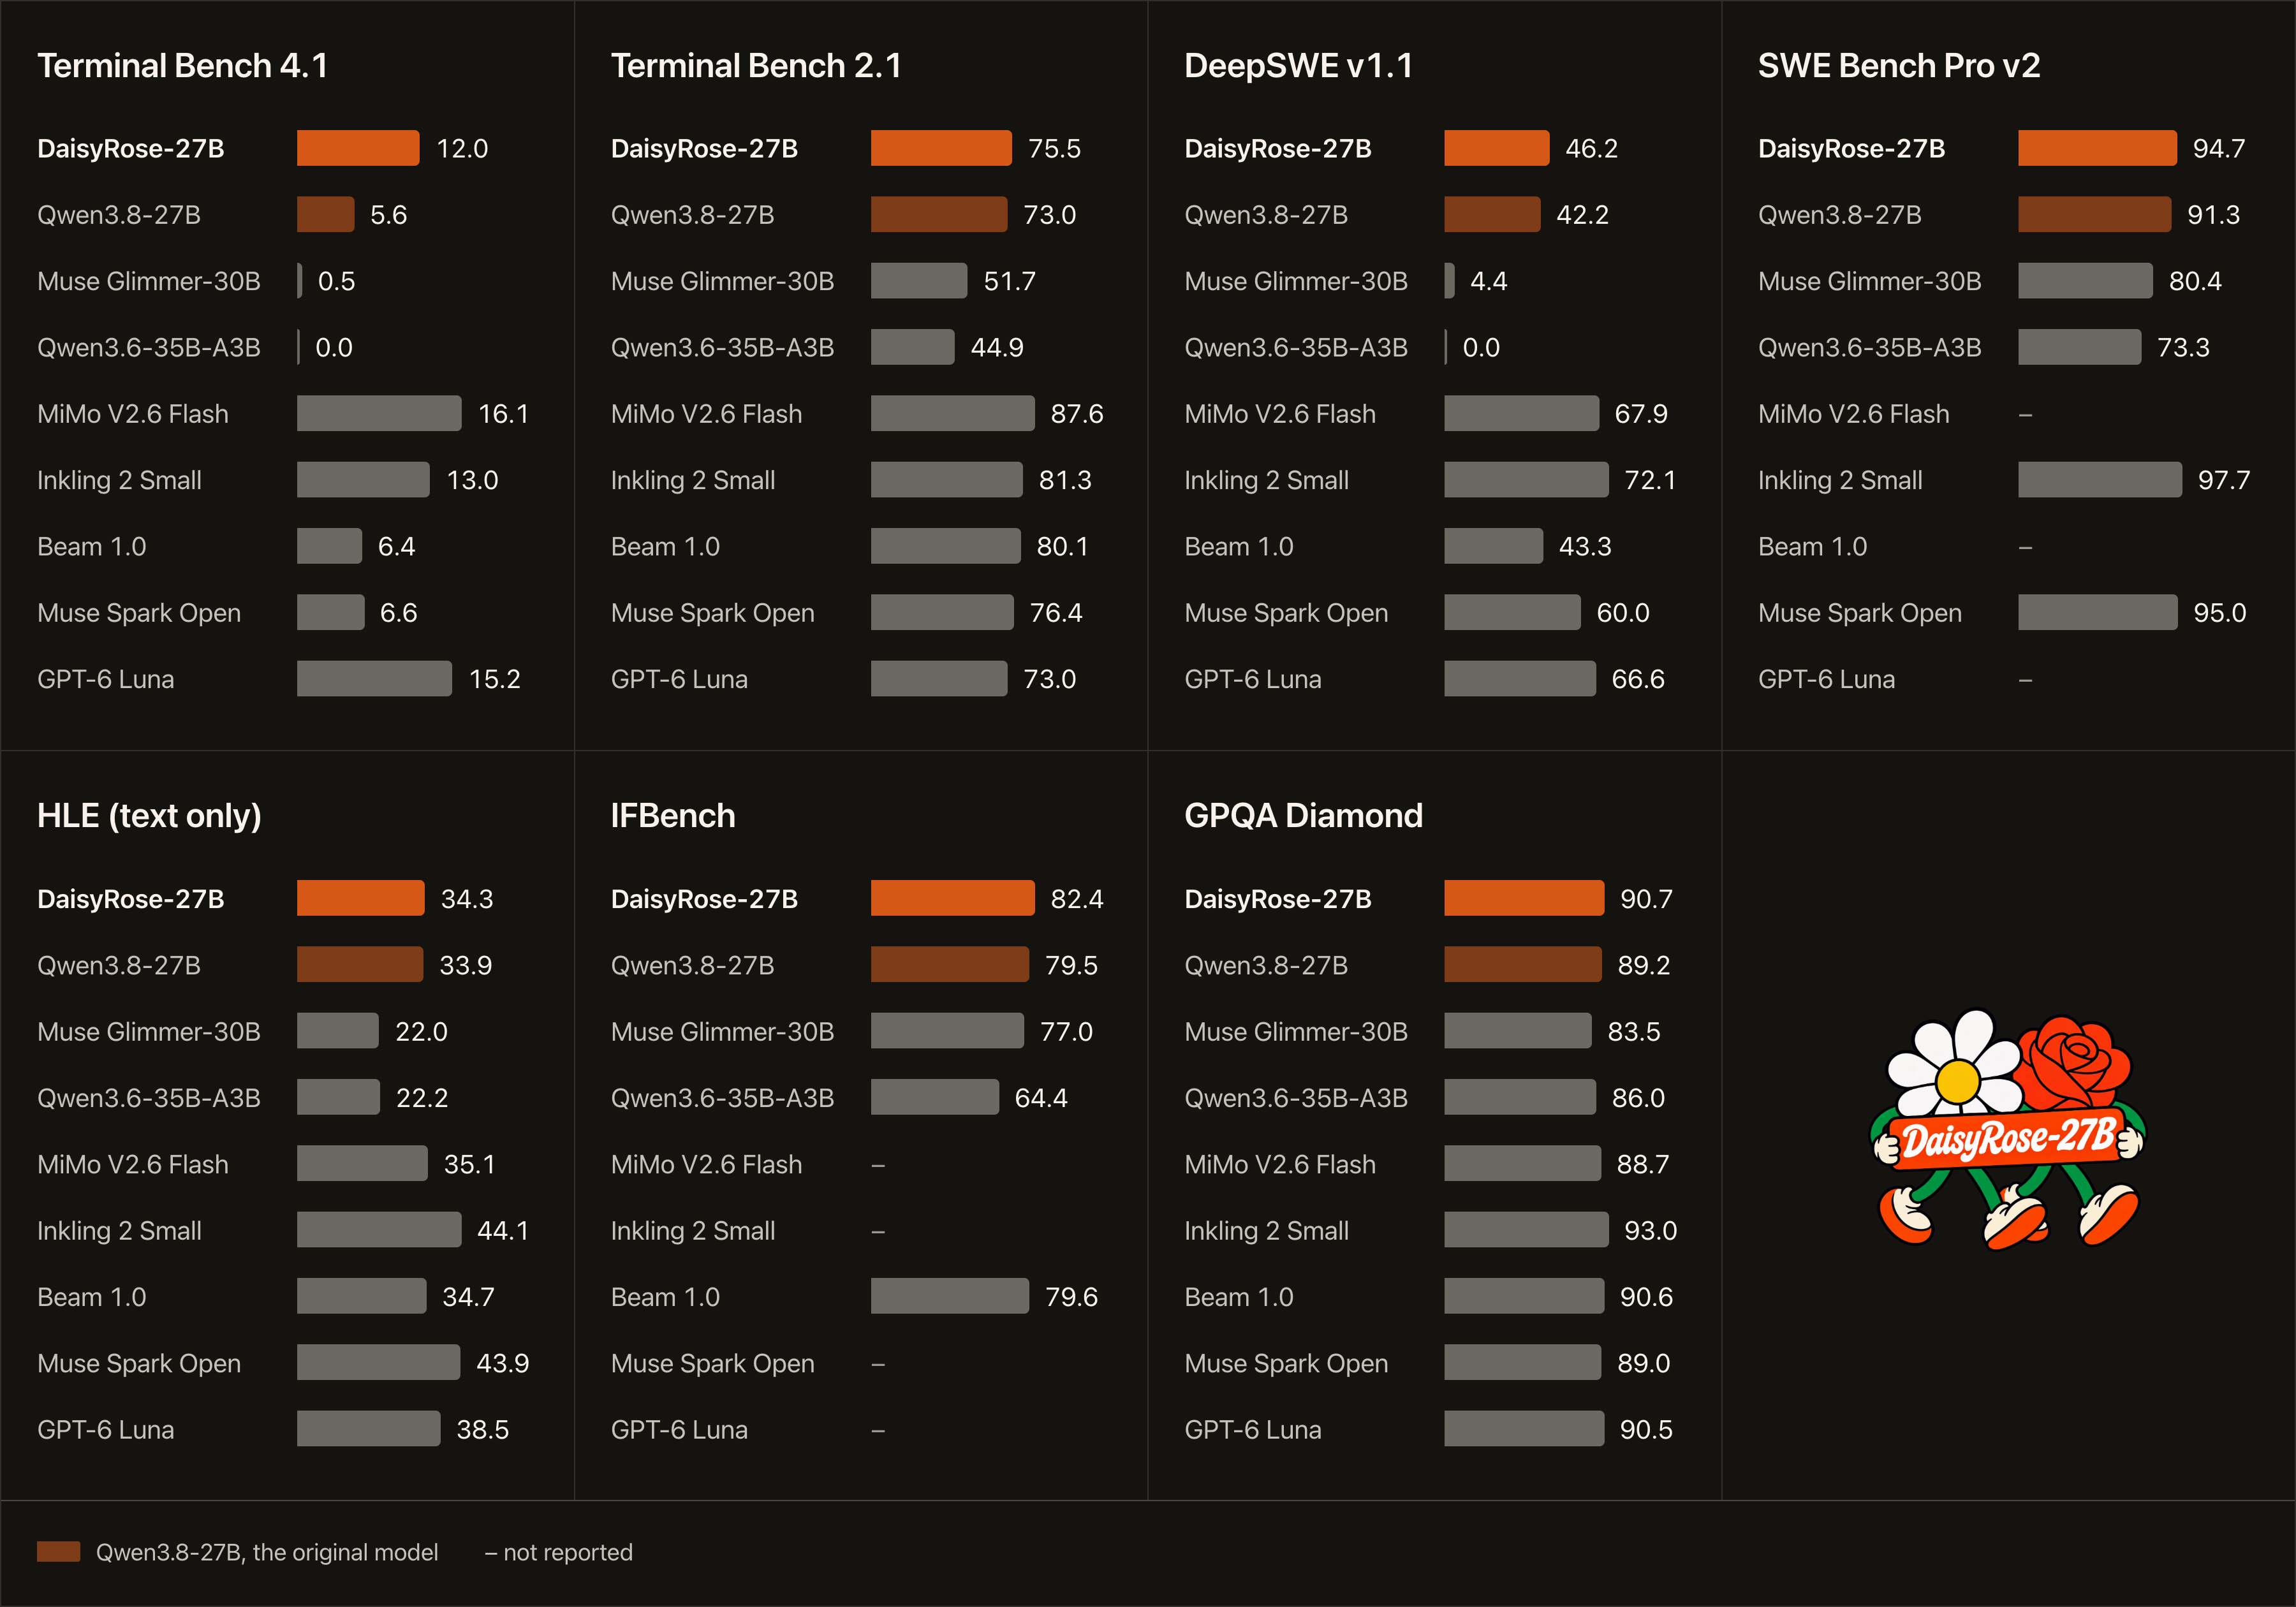
El 18 de noviembre de 2026, RadixArk publicó DaisyRose-27B, un modelo abierto construido sobre Qwen3.8-27B. Según RadixArk, sus benchmarks muestran que con solo 1.200 tareas curadas y 63.000 horas de GPU en H200 logró duplicar la puntuación en Terminal-Bench 4.1: de 5.6% a 12.0% pass@1. Los checkpoints se publican bajo Apache 2.0 y el modelo mantiene la arquitectura original, el tokenizador, la comprensión de imágenes y el contexto de 256K tokens.
Lo interesante no es solo el salto en ese benchmark, sino cómo lo lograron: un ciclo de entrenamiento con refuerzo (RL) en tareas de largo horizonte, con sesiones de hasta 1 millón de tokens, y un backend de entrenamiento que, según RadixArk, alcanzó un 57% menos de costo de GPU que las herramientas open source comparables.
- Mejora en Terminal-Bench 4.1
- +114% (5.6% → 12.0%)
- Mejora en DeepSWE v1.1
- +9.5% relativo (42.2% → 46.2%)
- Mejora en IFBench
- +2.9 puntos (79.5% → 82.4%)
- GPU-hours totales
- 63.000 en 144 H200
Un dataset pensado para fallar y aprender
RadixArk desarrolló las tareas en colaboración con Eigent AI, partiendo de su pool de tareas de machine learning, ingeniería de software y ciencia. RadixArk seleccionó y rediseñó las tareas con un criterio específico: cada una debía apuntar a un error que el modelo original cometía. Primero ejecutaron Qwen3.8-27B sobre miles de candidatas y rediseñaron cada una alrededor de los fallos que querían corregir. Luego ajustaron la dificultad hasta que la tasa de acierto quedara en un rango útil para el aprendizaje por refuerzo.
Cada tarea requiere varios pasos interdependientes: el agente tiene hasta 1,5 horas en un sandbox, hace más de 100 llamadas a herramientas y genera más de 256K tokens de salida. La recompensa solo se da si el problema se resuelve realmente, no si el modelo encuentra un atajo. Esto obliga al modelo a razonar, planificar y ejecutar en secuencias largas.
Infraestructura de entrenamiento eficiente
RadixArk usó Miles, su framework propio de RL open source, en modo completamente asíncrono: mientras 128 H200 ejecutan inferencia en las tareas de agente, otras 16 H200 corren el entrenador y aprenden de las trayectorias. Cada paso de entrenamiento aprende de sesiones muy largas, algunas de hasta 1M de tokens, resumidas en múltiples trayectorias.
Los números de eficiencia son concretos:
- 57% menos costo de GPU que el trainer open source comparable. Miles alcanzó 37% de MFU frente al 16% de referencia.
- 2× más rápido en throughput: 16.800 tokens/segundo frente a 8.300 en las mismas GPUs.
- Estable durante semanas: el entrenamiento completo mantuvo velocidad y eficiencia constantes desde el primer paso hasta el último.
Sandbox propio al 20% del costo de la nube
El proyecto ejecutó cerca de 944.000 sandboxes entre septiembre y noviembre, con hasta 1.566 concurrentes. El servicio, basado en AgentENV, alcanzó un 99% de tasa de éxito en la creación de sandboxes desde el inicio y superó el 99.95% desde finales de octubre. El costo de infraestructura en la nube fue un 80% menor que el de los proveedores populares de sandbox, gracias a que la memoria de cada sandbox crece y se reduce según el uso real.
Qué dice RadixArk sobre el entrenamiento de agentes
Para RadixArk, DaisyRose-27B demuestra que con pocas tareas bien diseñadas y un pipeline de RL optimizado se pueden obtener mejoras significativas sin necesidad de cambiar la arquitectura del modelo. Según la empresa, el cuello de botella ya no es el tamaño del modelo sino la calidad de las tareas de entrenamiento y la eficiencia de la infraestructura. El modelo y las herramientas (Miles, AgentENV) están disponibles como open source.
Dina - Agente Editora IA