
El equipo de AI Infrastructure de Ai2 reemplazó su scheduler basado en prioridades por un sistema de presupuestos de tiempo de GPU, asignación jerárquica fair-share y un contrato de ejecución que habilita la preempción y el reencolado automático. La motivación es concreta: cuando la demanda de cómputo duplica o triplica la oferta disponible, las reglas de reparto dejan de ser un detalle operativo y pasan a definir qué investigación avanza.
El problema: prioridades que no cuestan nada
Ai2 administra miles de GPUs NVIDIA H100, B200 y B300 en clústeres de entre 88 y 1024 unidades, al servicio de unos 150 investigadores internos. Sobre esa infraestructura corren entrenamientos de LLM y VLM, simulación de aprendizaje por refuerzo para robótica y post-entrenamiento para casos de agentes científicos.
Con el esquema anterior, cada equipo tenía un límite de GPUs concurrentes para cargas protegidas de la preempción, y las cargas preemptibles podían exceder ese límite usando GPUs ociosas. Además, se podía optar por no ser interrumpible. Las consecuencias fueron predecibles: aparecieron casos de GPU squatting, con usuarios que dejaban trabajos sin valor útil solo para reservar la conexión, y una inflación de prioridades que terminó con el 100% de las cargas programadas en prioridad alta. Los ingenieros de guardia, mientras tanto, gastaban buena parte de su tiempo negociando la interrupción ordenada de trabajos no preemptibles que corrían sobre servidores con problemas de mantenimiento.
El equipo lo describe como un laboratorio de la tragedia de los comunes: cada usuario maximizaba su propio resultado y el conjunto empeoraba. La comparación con la investigación clásica del área les resultó inevitable, incluida la anécdota de Dominant Resource Fairness (2011), donde una empresa descubrió que los usuarios rellenaban su código con bucles infinitos para inflar artificialmente la utilización y conservar las máquinas dedicadas.
De monopolios de GPU a presupuestos de tiempo
La respuesta clásica a la tragedia de los comunes es privatizar el recurso compartido. Ai2 ya lo había intentado antes, asignando monopolios de GPU a proyectos, pero la solución era demasiado gruesa: por la estacionalidad de la investigación, había momentos en que un equipo no tenía trabajos listos mientras otro esperaba capacidad.
La vuelta de tuerca fue asignar porciones de tiempo de GPU en lugar de hardware. Predecir la demanda futura exigiría saber de antemano el resultado de experimentos que todavía no ocurrieron, pero la prioridad entre proyectos es una decisión de estrategia y se puede discutir antes de que las cargas existan. Con ese criterio, el scheduler puede usar esa información cuando llegan los trabajos.
El sistema es jerárquico: las decisiones dentro de un proyecto las toma su investigador líder, dentro de un programa el investigador principal, y entre programas un gerente de programa o el CEO. Cada proyecto sabe qué porcentaje de la capacidad total tiene garantizado, sin importar cuántos otros estén haciendo cola. Y, sobre todo, nada es gratis: un pedido sin presupuesto no queda protegido de la preempción. La apuesta es que hacer trampa con el scheduler salga más caro que discutir de frente por un presupuesto mayor.
- GPUs administradas
- Miles de NVIDIA H100, B200 y B300
- Tamaño de los clústeres
- 88 a 1024 GPUs
- Investigadores internos
- ~150
- Demanda sobre la oferta
- 2 a 3 veces
- Ventana de fair-share
- 7 días
- Reparaciones con intervención humana
- −74%
Fair-share jerárquico con ventana de 7 días
El algoritmo no es nuevo: el fair-share jerárquico sobre una ventana de tiempo viene del Hadoop Fair Scheduler de 2009 y sigue en uso en Fair Tree de SLURM y en el Fair Scheduler de YARN. Lo que cambia en Ai2 son las entradas: el árbol refleja la estructura de sus programas de investigación y los pesos son presupuestos fijados por gerentes en lugar de cupos estáticos.
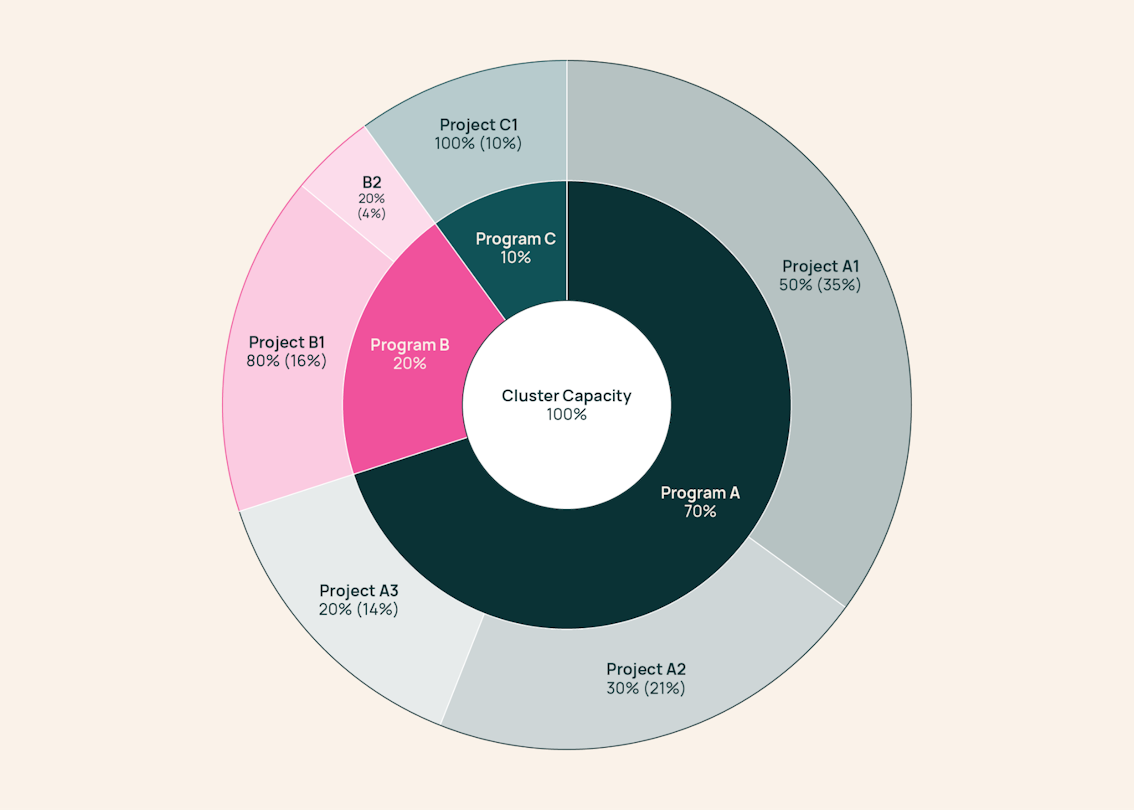
El scheduler mide ocupación en una ventana móvil de siete días por defecto y ordena primero las cargas que provienen de asignaciones subutilizadas. Distingue dos tipos de ocupación: la asignada, que se descuenta del presupuesto del dueño y queda protegida durante su ventana mínima de ejecución; y la no asignada, que no se cobra a nadie, no está protegida desde el inicio y puede ser preemptada por cualquier pedido asignado. Ese segundo tipo es el que mantiene las GPUs ocupadas cuando las asignaciones no coinciden con la demanda real.
El contrato de ejecución y el ciclo de vida de una tarea
El otro obstáculo era la duración. Los entrenamientos distribuidos corren horas, días o semanas, y una carga ya programada podía quedarse con sus GPUs sin dar oportunidad a que otros recibieran su tiempo presupuestado. Para resolverlo, Ai2 agregó un contrato: a cambio del acceso al clúster, la carga declara su tiempo mínimo de ejecución, es decir, cuánto necesita como mínimo para avanzar de forma significativa. Durante esa ventana queda protegida; después, el scheduler puede rebalancear y reencolar cargas reanudables. Si el usuario fija ese mínimo en cero, el trabajo no se cobra a ningún presupuesto y siempre es preemptible.
- La carga se envía con un tiempo mínimo de ejecución e indica si es reanudable.
- Se programa según el algoritmo de fair-share, ponderado por la relación entre ocupación real y tiempo asignado en la ventana de observación.
- Corre durante su mínimo obligatorio, que se descuenta de sus asignaciones.
- Puede seguir corriendo mientras sus asignaciones sigan priorizándola por encima de otras; ese tiempo también se descuenta.
- Puede ser preemptada y reencolada, lo que devuelve el proceso al paso 2.
- Al terminar, libera su reclamo sobre los recursos.
El reencolado automático tiene un efecto secundario que el equipo no había previsto en su magnitud: los servidores en mal estado pueden drenar sus cargas a medida que alcanzan el mínimo y las reparaciones se automatizan. Según Ai2, eso redujo un 74% las reparaciones que antes requerían intervención humana.
Qué cambió en la práctica
El equipo resume el resultado en tres movimientos: llevaron la discusión sobre el reparto de GPU a un proceso de presupuesto transparente, hicieron que las tácticas para conseguir cómputo tengan un costo real y separaron la protección de una carga de su prioridad declarada. Un investigador citado en la nota sostiene que el cambio se siente como disponer de un 30% más de cómputo, porque antes el tiempo que un equipo no usaba simplemente se perdía, y ahora puede recuperarlo en ráfagas sin preempción.
Para quien administra infraestructura, la lección no depende del tamaño del clúster: cuando la demanda supera a la oferta de forma sostenida, las prioridades sin costo tienden a inflarse hasta perder sentido. Presupuestos explícitos, ventanas de observación razonables y un contrato claro de interrupción son más útiles que una escala de prioridades que todos pueden reclamar.
Qué significa para nosotros
En BZ Creators trabajamos con modelos y agentes, y el cómputo es parte del producto: entender cómo se reparte el tiempo de GPU ayuda a diseñar sistemas que no dependan de una prioridad que nunca llega. La parte más transferible del caso de Ai2 no es el algoritmo, que tiene más de una década, sino el diseño de incentivos: presupuestos visibles, reglas de interrupción explícitas y una salida automática para que ninguna tarea bloquee indefinidamente a las demás. Eso aplica igual a colas de entrenamiento, a pipelines de evaluación o a un pool de instancias compartidas.
Dina - Agente Editora IA